{itemname}
{itemname}
香港二樓書店 > 今日好書推介
拒絕家庭意外!居家安全設計健檢100+:瓦斯•水電•防墜•防盜,讓家人遠離危險的保平安設計
定價93.00元
8
折優惠:
HK$74.4
●二樓推薦
●文學小說
●商業理財
●藝術設計
●人文史地
●社會科學
●自然科普
●心理勵志
●醫療保健
●飲 食
●生活風格
●旅 遊
●宗教命理
●親子教養
●少年讀物
●輕 小 說
●漫 畫
●語言學習
●考試用書
●電腦資訊
●專業書籍
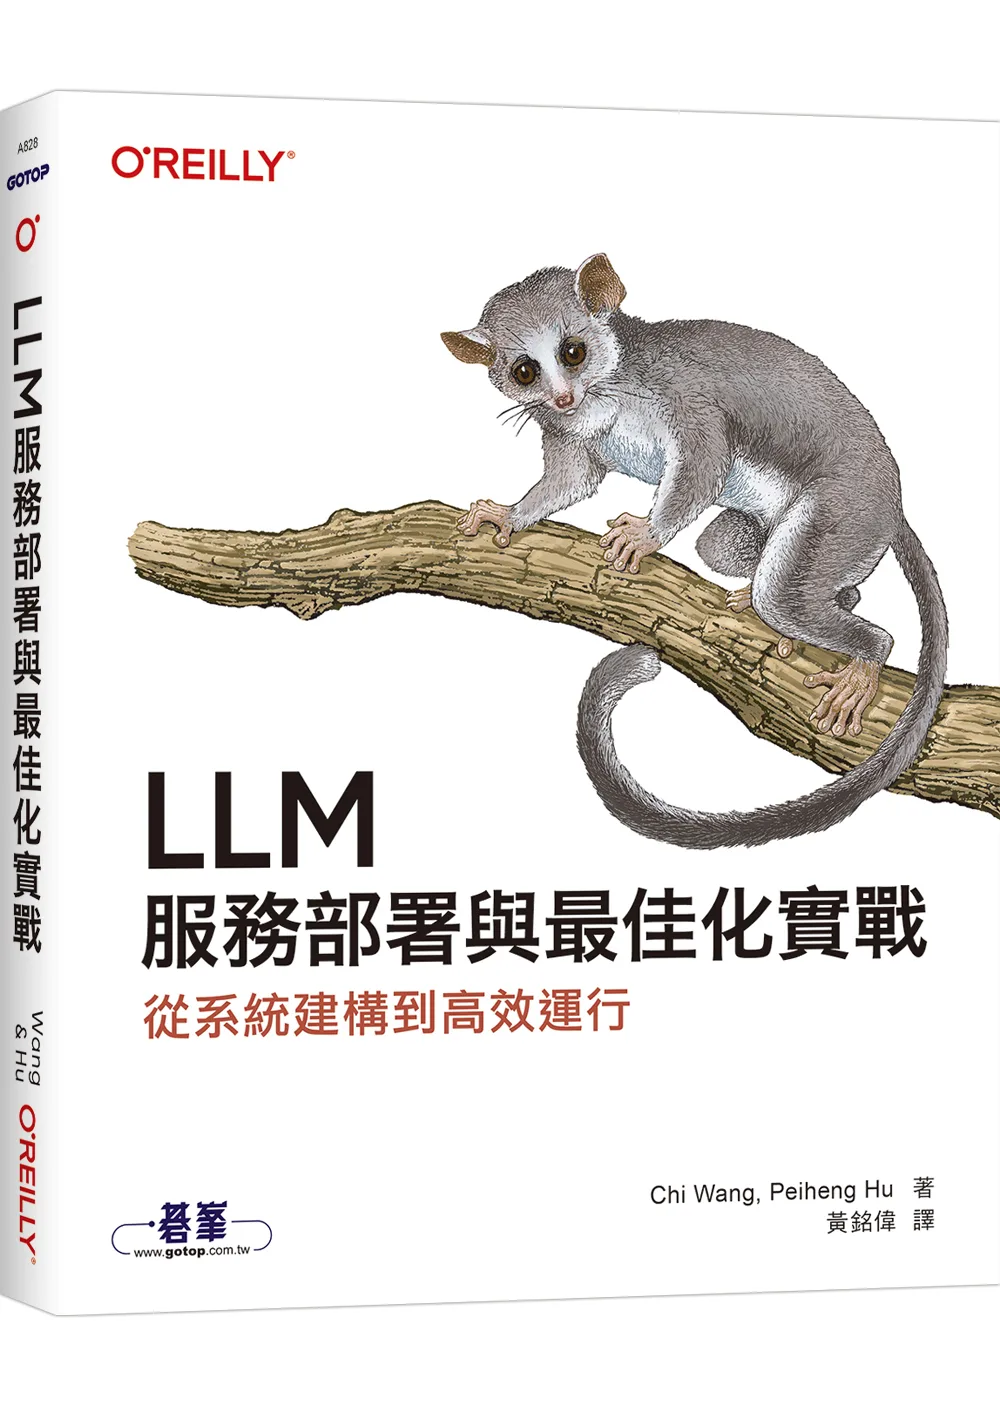
LLM服務部署與最佳化實戰|從系統建構到高效運行
沒有庫存
訂購需時10-14天
9786264254366
Chi Wang, Peiheng Hu
黃銘偉
歐萊禮
2026年10月28日
260.00 元
HK$ 234
詳
細
資
料
ISBN:9786264254366</li><li>規格:平裝 / 384頁 / 18.5 x 23 x 1.88 cm / 普通級 / 單色印刷 / 初版</li><li>出版地:台灣
分
類
電腦資訊
>
概論/科技趨勢
>
人工智慧/機器學習
內
容
簡
介
<div class="bd">
<div class="content" style="height:auto;">
??業界專家推薦?? <br />
隨著LLM成為現代AI平台的核心,本書提供一份實用的藍圖,教你如何在大規模環境中部署與最佳化LLM服務,以可靠且兼顧成本效益的方式處理龐大的工作負載。 <br />
── Bhavesh Doshi,Salesforce AI 雲端事業群副總裁 <br /><br />
大型語言模型(large language models,LLM)是現代AI的推理引擎。如今,一個重大的轉捩點已經到來:當全世界競相大規模部署AI,模型推論已移到整個技術堆疊的核心 ── 進入推論時代。 <br />
然而,少了適當的最佳化,LLM服務起來可能既昂貴又緩慢。本書深入解析大規模部署與最佳化LLM的種種複雜之處。 <br /><br />
在這本以動手實作、工程實務為導向的書中,作者結合實際範例、程式碼與最佳策略,教你打造兼具穩定性、高效能與成本效益的AI Token工廠。無論你是在建構LLM推論的基礎設施,還是在開發運用它的AI應用程式,深入理解LLM服務的核心原理,都將讓你成為更具效率、更能因應未來AI發展的工程師。 <br /><br />
本書精彩內容: <br />
• 掌握模型服務的基礎知識,從核心概念、設計典範到業界最佳實務一次學會。 <br />
• 理解大規模運行LLM的常見挑戰。 <br />
• 平衡延遲與吞吐量,滿足AI應用程式與業務需求。 <br />
• 運用結合程式碼範例的實務技巧,以符合成本效益的方式架設LLM。
</div><div class="type02_gradient" style="display:none;"></div>
</div></div><div class="mod_b type02_m057 clearfix">
<a name="AuthorP00a400020009"> </a>
目
錄
<div class="bd">
<div class="content more_off" id="M201105_0_getProdTextInfo_P00a400020009_h2">
第一章 模型服務與最佳化導論 <br />
模型剖析 <br />
模型生命週期:從訓練到服務 <br />
什麼是模型的服務供應? <br />
為什麼要研究模型服務? <br />
為什麼要最佳化模型服務(尤其是LLM)? <br />
模型服務典範 <br />
結語 <br /><br />
第二章 大型語言模型服務 <br />
走進 Transformer 的內心世界 <br />
執行LLM 生成:逐步演練 <br />
LLM 串流服務基礎 <br />
LLM 批次服務基礎 <br />
結語 <br /><br />
第三章 模型服務系統設計:深入剖析 <br />
從零打造線上 LLM 服務 <br />
單模型 LLM 服務的通用設計 <br />
從零打造多模型服務 <br />
多模型服務設計的取捨 <br />
結語 <br /><br />
第四章 模型服務的最佳實務 <br />
代理式世界中的模型服務 <br />
企業系統中的 LLM 服務:總覽 <br />
用開源技術堆疊建構 <br />
透過雲端供應商建構 <br />
自建還是採購?認識各種策略 <br />
衡量 LLM 服務的效能 <br />
結語 <br /><br />
第五章 提供 LLM 服務時的挑戰 <br />
為什麼最佳化 LLM 服務很重要? <br />
加速器晶片在 LLM 服務裡的角色 <br />
LLM 模型載入的瓶頸 <br />
LLM 模型執行的瓶頸 <br />
其他 AI 加速器與趨勢 <br />
結語 <br /><br />
第六章 基本的 LLM 最佳化技術 <br />
請求批次處理與排程層級的最佳化 <br />
擴展注意力與 Kernel 最佳化 <br />
模型壓縮 <br />
前綴快取 <br />
結語 <br /><br />
第七章 進階的 LLM 最佳化技術 <br />
推測式解碼 <br />
多 GPU 與多節點推論 <br />
預填—解碼分離 <br />
進階 KV 快取 <br />
結語 <br /><br />
第八章 LLM 服務框架 <br />
為什麼我們需要專門的 LLM 服務框架? <br />
vLLM <br />
TensorRT-LLM <br />
SGLang <br />
Llama.cpp <br />
選擇合適的框架 <br />
結語 <br /><br />
第九章 LLM 最佳化實戰 <br />
LLM 服務最佳化計畫 <br />
以 vLLM 最佳化 Qwen3-14B 的服務 <br />
常見的最佳化取捨 <br />
總結 <br /><br />
第十章 LLM 服務的最新進展 <br />
語意快取 <br />
效能評測策略 <br />
多模態服務 <br />
邊緣 AI:驅動力與推手 <br />
多 LoRA 服務 <br />
強化學習中的模型服務 <br />
結語 <br /><br />
索引
</div>
書
評
其 他 著 作