{itemname}
{itemname}
香港二樓書店 > 今日好書推介
拒絕家庭意外!居家安全設計健檢100+:瓦斯•水電•防墜•防盜,讓家人遠離危險的保平安設計
定價93.00元
8
折優惠:
HK$74.4
●二樓推薦
●文學小說
●商業理財
●藝術設計
●人文史地
●社會科學
●自然科普
●心理勵志
●醫療保健
●飲 食
●生活風格
●旅 遊
●宗教命理
●親子教養
●少年讀物
●輕 小 說
●漫 畫
●語言學習
●考試用書
●電腦資訊
●專業書籍
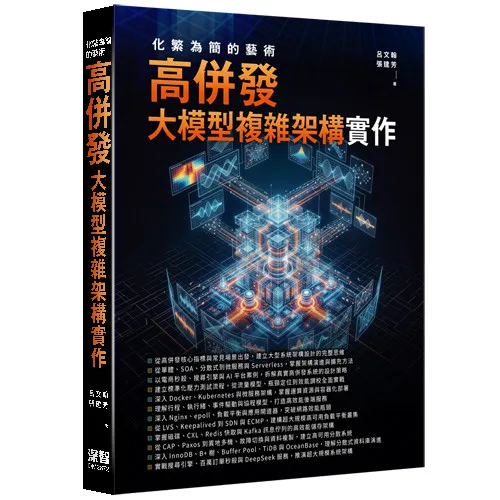
化繁為簡的藝術 - 高併發大模型複雜架構實作
沒有庫存
訂購需時10-14天
9786267889701
呂文翰、張建芳
深智數位
2026年9月19日
327.00 元
HK$ 277.95
詳
細
資
料
ISBN:9786267889701</li><li>規格:平裝 / 392頁 / 23 x 17 x 1.96 cm / 普通級 / 單色印刷 / 初版</li><li>出版地:台灣
分
類
電腦資訊
>
程式設計
>
軟體工程
內
容
簡
介
<div class="bd">
<div class="content" style="height:auto;">
<p>☆從高併發核心指標與常見場景出發,建立大型系統架構設計的完整思維<br />
☆從單體、SOA、分散式到微服務與Serverless,掌握架構演進與擴充方法<br />
☆以電商秒殺、搜尋引擎與AI平台案例,拆解真實高併發系統的設計策略<br />
☆建立標準化壓力測試流程,從流量模型、瓶頸定位到效能調校全面實戰<br />
☆深入Docker、Kubernetes與微服務架構,掌握運算資源與容器化部署<br />
☆理解行程、執行緒、事件驅動與協程模型,打造高效能後端服務<br />
☆深入Nginx、epoll、負載平衡與應用閘道器,突破網路效能瓶頸<br />
☆從LVS、Keepalived到SDN與ECMP,建構超大規模高可用負載平衡叢集<br />
☆掌握磁碟、CXL、Redis快取與Kafka訊息佇列的高效能儲存架構<br />
☆從CAP、Paxos到異地多機、故障切換與資料複製,建立高可用分散系統<br />
☆深入InnoDB、B+樹、Buffer Pool、TiDB與OceanBase,理解分散式資料庫演進<br />
☆實戰搜尋引擎、百萬訂單秒殺與DeepSeek服務,推演超大規模系統架構<br />
?<br />
本書共分23章。第一章介紹高併發概念、指標與架構演進;第二章說明高併發架構設計方法;第三章解析搜尋、秒殺與AI平台案例;第四章介紹壓力測試;第五章介紹虛擬化、Docker與Kubernetes;第六章解析行程、執行緒與協程;第七章介紹Web Server、Nginx與epoll;第八章介紹負載平衡與應用閘道器;第九章深入LVS與大型負載平衡叢集;第十章介紹儲存與CXL;第十一章介紹快取架構;第十二章介紹Kafka與訊息佇列;第十三章說明CAP、分散式交易與Paxos;第十四章介紹異地多機與故障處理;第十五章介紹運算層高可用;第十六章介紹儲存層高可用;第十七章解析InnoDB、B+樹與Buffer Pool;第十八章回顧四代分散式資料庫;第十九章比較TiDB與OceanBase;第二十章實作全網搜尋引擎;第二十一章實作百萬訂單秒殺系統;第二十二章推演DeepSeek高併發架構;第二十三章探討無限容量架構的設計思路。<br />
?</p>
</div><div class="type02_gradient" style="display:none;"></div>
</div></div><div class="mod_b type02_m057 clearfix">
<a name="AuthorP00a400020009"> </a>
目
錄
<div class="bd">
<div class="content more_off" id="M201105_0_getProdTextInfo_P00a400020009_h2">
<p><span style="color:#0000ff;"><strong>▌第一部分 高併發</strong></span><br /><strong>第1 章 高併發系統入門</strong><br />
1.1 什麼是高併發<br />
1.2 高併發系統的關鍵指標<br />
1.3 常見高併發場景<br />
1.3.1 電商秒殺與社群網路熱點<br />
1.3.2 金融交易<br />
1.3.3 網路遊戲<br />
1.3.4 網路影音與直播<br />
1.4 系統架構的演變<br />
1.4.1 單體架構<br />
1.4.2 SOA 與分散式架構<br />
1.4.3 微服務架構<br />
1.4.4 無伺服器架構<br />
1.5 如何學習本書<br />
1.5.1 舊系統改造學習路徑<br />
1.5.2 新系統架設學習路徑<br />
?<br /><strong>第2 章 揭秘高併發架構的設計套路</strong><br />
2.1 思維躍遷:從使用者到架構師<br />
2.2 第一步:動態、靜態資源分開部署<br />
2.3 第二步:資料庫獨立部署<br />
2.4 第三步:將應用、資料庫、網路依次叢集化<br />
2.4.1 應用叢集化<br />
2.4.2 資料庫叢集化<br />
2.4.3 建構高可用的網路基礎設施<br />
2.5 真實案例:一個CMS 網站的效能最佳化之路<br />
2.5.1 動態、靜態資源分離與引入Elasticsearch<br />
2.5.2 資料層最佳化:MySQL 索引與Redis 快取<br />
2.5.3 應用層最佳化與架構思考<br />
2.5.4 實作基於 IP 與使用者代理的多層限流策略<br />
?<br /><strong>第3 章 高併發系統案例剖析</strong><br />
3.1 案例1:搜尋引擎<br />
3.1.1 搜尋引擎架構概述<br />
3.1.2 高併發挑戰與架構對策<br />
3.1.3 搜尋引擎的最佳化與演進<br />
3.2 案例2:電商「雙11」秒殺—每分鐘處理100 萬筆訂單<br />
3.2.1 存取層架構:靜態資源加速與動態資源管控<br />
3.2.2 應用層設計:GraphQL 的工程價值<br />
3.2.3 資料層設計:資料庫與快取的協同<br />
3.3 案例3:人工智慧平臺—從ChatGPT 到DeepSeek<br />
3.3.1 人工智慧平臺的高併發特性與挑戰<br />
3.3.2 DeepSeek 架構解析:從MoE 到軟硬體協同最佳化<br />
?<br /><strong>第4 章 如何正確地進行壓力測試</strong><br />
4.1 壓力測試的核心理念<br />
4.2 壓力測試的標準化流程<br />
4.3 高併發系統中的壓力測試<br />
4.4 案例解析:某電商平臺的壓力測試實戰<br />
4.4.1 專案背景與壓力測試目標<br />
4.4.2 設計與執行壓力測試方案<br />
4.4.3 瓶頸發現與調校實踐<br />
?<br /><span style="color:#0000ff;"><strong>▌第二部分 高效能</strong></span><br /><strong>第5 章 高效能運算</strong><br />
5.1 透過負載平衡實現水平擴展<br />
5.2 伺服器虛擬化<br />
5.3 理解軟體相容性與虛擬化技術<br />
5.4 詳解容器技術<br />
5.4.1 容器的核心隔離技術:chroot、namespaces 與cgroups<br />
5.4.2 Docker 的崛起:以應用為中心的映像檔思想<br />
5.5 軟體定義運算:Kubernetes<br />
5.5.1 天時、地利、人和:Kubernetes 的崛起之道<br />
5.5.2 Kubernetes 哲學:軟體定義一切<br />
5.6 Spring Cloud:虛擬機器時代的微服務基石<br />
5.7 軟體架構本質上是軟體團隊的組織架構<br />
5.8 實戰:用Docker 部署靜山平臺<br />
5.8.1 方法一:將所有軟體都安裝在一個容器內<br />
5.8.2 方法二:將多個容器部署在同一個Pod 內<br />
5.8.3 方法三:透過Ingress 和服務網格管理叢集流量<br />
?<br /><strong>第6 章 CPU 資源管理:行程、執行緒、協程</strong><br />
6.1 網際網路系統規模發展史<br />
6.1.1 全球資訊網的誕生與靜態網頁時代<br />
6.1.2 Web 2.0 與海量並行的崛起<br />
6.1.3 瞬時洪峰的終極挑戰:春晚紅包<br />
6.2 主流後端語言的演變<br />
6.2.1 行程模型:PHP 與阻塞I/O<br />
6.2.2 執行緒模型:Java 的統治與JVM 生態<br />
6.2.3 事件驅動模型:Node.js 的非同步革命<br />
6.2.4 協程模型:Go 語言的新紀元<br />
6.2.5 其他後端技術的興衰之路<br />
6.3 實戰:使用協程開發高效能爬蟲<br />
6.3.1 爬蟲工作流程<br />
6.3.2 使用協程最佳化爬蟲效能<br />
6.3.3 開源爬蟲架構解析<br />
?<br /><strong>第7 章 網路高效能之一:至關重要的Web Server 軟體</strong><br />
7.1 Apache 的誕生與發展<br />
7.2 主流Web Server 架構效能實戰對比<br />
7.2.1 3 種並行模型介紹<br />
7.2.2 Apache 與Nginx 核心架構效能壓力測試<br />
7.2.3 epoll 與prefork 模型對比<br />
7.3 Nginx 的誕生<br />
7.4 I/O 多工技術演進:從select 到epoll<br />
7.4.1 epoll 的核心原理與Nginx 協同機制<br />
7.4.2 實戰:Nginx 用於電商秒殺系統<br />
?<br /><strong>第8 章 網路高效能之二:負載平衡和應用閘道器</strong><br />
8.1 核心概念:負載平衡與應用閘道器<br />
8.1.1 什麼是負載平衡<br />
8.1.2 什麼是應用閘道器<br />
8.1.3 應用閘道器的更多價值<br />
8.1.4 實戰:「住范兒」電商平臺的真實網路架構圖<br />
8.2 實戰起步:從單體架構到高併發閘道器<br />
8.2.1 京東離峰期併發量估算<br />
8.2.2 Kong 閘道器需要的硬體規模<br />
8.2.3 技術選型:深入瞭解Kong 閘道器<br />
8.3 詳解網路協定堆疊<br />
8.3.1 網路分層模型與資料封裝<br />
8.3.2 應用層(HTTP)與傳輸層(TCP)<br />
8.3.3 網路層(IP)與資料連結層(MAC)<br />
8.4 詳解負載平衡器<br />
8.4.1 技術原理:負載平衡器如何工作<br />
8.4.2 效能對比:為何四層負載平衡更快<br />
8.4.3 最終架構:5 萬QPS 電商平臺實戰<br />
?<br /><strong>第9 章 網路高效能之三:超大規模負載平衡叢集</strong><br />
9.1 軟體定義網路(SDN)技術簡介<br />
9.2 負載平衡技術的發展史<br />
9.2.1 第一代:硬體負載平衡<br />
9.2.2 第二代:軟體負載平衡<br />
9.3 交換器技術<br />
9.4 LVS 技術詳解<br />
9.4.1 LVS 基本原理<br />
9.4.2 LVS 設計思想<br />
9.4.3 OSPF/ECMP 負載平衡協定<br />
9.5 基於Keepalived 建置高可用性LVS 叢集<br />
9.6 突破單台伺服器的頻寬極限<br />
9.6.1 單機效能最佳化:從使用者態網路到鎖最佳化<br />
9.6.2 水平擴充:設計全冗餘高可用性叢集<br />
9.6.3 叢集容量計算與價值分析<br />
9.7 硬體廠商的使用者態網路實踐<br />
9.8 下一個挑戰:資料庫<br />
?<br /><strong>第10 章 儲存高效能之一:磁碟</strong><br />
10.1 資料庫:從終極佇列到效能瓶頸<br />
10.2 儲存技術簡史<br />
10.2.1 集中式儲存<br />
10.2.2 分散式儲存<br />
10.2.3 集中式儲存和分散式儲存的優缺點對比<br />
10.3 I/O 技術展望:CXL 重塑未來<br />
10.3.1 CXL 的技術基石與時代背景<br />
10.3.2 CXL:下一代I/O 技術詳解<br />
10.3.3 CXL 的應用場景:網路卡與大模型<br />
?<br /><strong>第11 章 儲存高效能之二:快取</strong><br />
11.1 快取的原理與價值<br />
11.2 快取的核心問題與讀/ 寫模型<br />
11.2.1 基礎讀/ 寫模型與快取擊穿<br />
11.2.2 快取雪崩問題<br />
11.2.3 快取穿透與布隆過濾器<br />
11.2.4 快取的更新、淘汰與預熱策略<br />
11.2.5 快取高可用性<br />
11.3 快取在架構設計中的價值<br />
11.3.1 一致性與效能的權衡<br />
11.3.2 分散式快取與微服務<br />
11.3.3 案例教學:Elasticsearch 的快取設計<br />
11.4 實戰:電商平臺快取體系設計<br />
11.4.1 設計目標與多級快取架構<br />
11.4.2 核心業務場景快取方案<br />
11.4.3 快取更新與容災方案<br />
11.4.4 快取的監控與治理<br />
?<br /><strong>第12 章 儲存高效能之三:訊息佇列</strong><br />
12.1 秒殺架構的核心:訊息佇列<br />
12.2 Kafka 分散式訊息訂閱系統詳解<br />
12.2.1 應用場景<br />
12.2.2 核心概念與整體架構<br />
12.2.3 關鍵機制:分區、副本與高可用性<br />
12.3 訊息佇列的架構意義<br />
12.3.1 核心價值:實現非同步解耦與削峰填谷<br />
12.3.2 提升系統韌性:保障高可用性與微服務解耦<br />
12.3.3 支援高階架構:事件驅動與多樣化訊息處理<br />
12.3.4 總結<br />
12.4 真實案例:「住范兒」電商平臺的非同步下單流程架構<br />
?<br /><span style="color:#0000ff;"><strong>▌第三部分 高可用性</strong></span><br /><strong>第13 章 分散式交易:從CAP 到Paxos</strong><br />
13.1 分散式系統基礎<br />
13.1.1 CAP 定理簡介<br />
13.1.2 分散式系統的挑戰<br />
13.2 分散式交易的實作與權衡<br />
13.2.1 常用分散式交易協定<br />
13.2.2 分散式ACID 的難點與解決方案<br />
13.3 Paxos 共識演算法詳解<br />
13.3.1 Paxos 的誕生:在CAP 框架下尋求一致性<br />
13.3.2 演算法原理與執行流程<br />
13.3.3 關鍵特性、最佳化與變體<br />
13.3.4 應用場景與實踐挑戰<br />
?<br /><strong>第14 章 業務層高可用</strong><br />
14.1 異地多活<br />
14.1.1 核心理念與挑戰<br />
14.1.2 關鍵技術:資料、流量與監控<br />
14.1.3 演進趨勢與成本考量<br />
14.2 兩地三中心<br />
14.2.1 架構原理與佈局<br />
14.2.2 核心機制:資料同步與故障切換<br />
14.2.3 實施決策:成本與雲端方案<br />
14.3 業務層故障處理架構<br />
14.3.1 故障感知:發現問題<br />
14.3.2 故障隔離:排隊、降級、限流與熔斷<br />
14.3.3 故障自癒:自動恢復<br />
?<br /><strong>第15 章 運算層高可用性</strong><br />
15.1 主從架構<br />
15.2 雙主多活架構<br />
15.3 冗餘<br />
15.3.1 冗餘的原則與度量<br />
15.3.2 冗餘在架構設計中的應用<br />
15.4 故障切換與復原<br />
15.4.1 故障發現與自動切換<br />
15.4.2 資料一致性保障<br />
15.4.3 恢復流程與自動化維運體系<br />
?<br /><strong>第16 章 儲存層高可用性</strong><br />
16.1 高可用性儲存的基本概念<br />
16.2 資料複製技術<br />
16.2.1 複製模型:策略、拓樸與應用<br />
16.2.2 複製一致性模型與共識協定<br />
16.3 資料分片<br />
16.3.1 分片的設計:策略、分片鍵與實作<br />
16.3.2 資料分片的技術挑戰與對策<br />
16.4 資料分割<br />
16.4.1 資料分割與資料分片的區別<br />
16.4.2 分區策略與最佳化技術<br /><span style="color:#0000ff;"><strong>?<br />
▌第四部分 分散式資料庫</strong></span><br /><strong>第17 章 InnoDB 儲存引擎核心原理剖析</strong><br />
17.1 InnoDB 簡介<br />
17.1.1 InnoDB 的發展歷程<br />
17.1.2 InnoDB 的技術取捨<br />
17.2 B+ 樹在InnoDB 中的實現<br />
17.2.1 什麼是B+ 樹<br />
17.2.2 InnoDB 的頁組織方式:從索引頁到資料頁<br />
17.2.3 InnoDB 中的SQL 查詢過程<br />
17.3 InnoDB B+ 樹層級增長實證分析<br />
17.3.1 設計測試方案<br />
17.3.2 ibd 結構探測工具<br />
17.3.3 索引的起點:根頁的誕生<br />
17.3.4 結果分析<br />
17.4 「2000 萬列分表」問題<br />
17.4.1 從行長計算B+ 樹的容量極限<br />
17.4.2 B+ 樹層級增加對效能的影響與分表必要性<br />
17.4.3 應該何時分表<br />
17.5 記憶體快取Buffer Pool<br />
17.5.1 Buffer Pool 的LRU 演算法<br />
17.5.2 Buffer Pool 的最佳化方法<br />
?<br /><strong>第18 章 四代分散式資料庫發展史</strong><br />
18.1 單機資料庫的極限:不可能三角<br />
18.1.1 持久化、隔離與效能的權衡<br />
18.1.2 MySQL 的妥協與智慧<br />
18.2 突破讀取效能瓶頸:主從架構與讀/ 寫分離<br />
18.3 第一代分散式資料庫:仲介軟體<br />
18.4 第二代分散式資料庫:分散式KV 資料庫<br />
18.4.1 分散式時代的「新不可能三角」<br />
18.4.2 分散式鍵值資料庫放棄了交易隔離<br />
18.5 第三代分散式資料庫:NewSQL<br />
18.5.1 Spanner 的核心技術剖析<br />
18.5.2 Spanner 對CAP 定理的取捨<br />
18.6 第四代分散式資料庫:雲端資料庫<br />
18.6.1 亞馬遜Aurora 率先推出<br />
18.6.2 阿里雲PolarDB 後來居上<br />
18.6.3 雲端資料庫對CAP 定理的取捨<br />
18.7 討論與展望<br />
18.7.1 架構思想的演進:從Shared-Disk 到Shared-Nothing<br />
18.7.2 欄位儲存概念<br />
?<br /><strong>第19 章 中國產資料庫TiDB 與OceanBase</strong><br />
19.1 TiDB 的設計思路<br />
19.1.1 TiKV<br />
19.1.2 TiDB 對CAP 定理和「不可能三角」的選擇<br />
19.2 OceanBase 的設計思路<br />
19.2.1 資料分割與平行查詢<br />
19.2.2 基於LSM Tree 的儲存與記憶體架構<br />
19.2.3 OceanBase 對CAP 定理和「不可能三角」的選擇<br />
19.3 兩大資料庫的選型結論<br />
?<br /><span style="color:#0000ff;"><strong>▌第五部分 專案實戰與展望</strong></span><br /><strong>第20 章 全網搜尋引擎實戰</strong><br />
20.1 搜尋引擎總體架構<br />
20.2 全網路資料採集系統<br />
20.3 索引建構:從文本處理到分散式儲存<br />
20.3.1 文本預處理與建構倒排索引<br />
20.3.2 分散式索引的建置與更新<br />
20.3.3 索引最佳化:壓縮、儲存與合併<br />
20.4 核心排序演算法<br />
20.4.1 文本相關性演算法:BM25 與VSM<br />
20.4.2 連結權威性演算法:PageRank<br />
20.4.3 Proximity 演算法與綜合排序實戰<br />
20.5 查詢處理與效能最佳化<br />
20.5.1 搜尋的分散式執行過程<br />
20.5.2 高併發架構與效能最佳化策略<br />
20.6 檢驗效果<br />
?<br /><strong>第21 章 電商「雙11」秒殺實戰:每分鐘處理100 萬筆訂單</strong><br />
21.1 秒殺系統設計原則與架構概述<br />
21.2 訂單處理核心設計要點<br />
21.2.1 流量管控:多層限流與防重設計<br />
21.2.2 核心寫流程:庫存控制與分散式交易<br />
21.2.3 訂單非同步化<br />
21.3 檢驗效果<br />
21.3.1 壓力測試方案與監控體系<br />
21.3.2 驗證核心設計的有效性<br />
?<br /><strong>第22 章 DeepSeek 高併發架構設計實戰</strong><br />
22.1 LLM 服務的高併發特性與核心挑戰<br />
22.2 DeepSeek 高併發架構設計推演<br />
22.2.1 存取層與智慧調度<br />
22.2.2 高效能推理引擎與基礎設施<br />
22.2.3 系統韌性與可觀測性<br />
22.3 持續演進的架構<br />
?<br /><strong>第23 章 存在無限容量架構嗎</strong><br />
23.1 系統邊界:從現實世界看分區合理性<br />
23.2 核心策略:基於地理位置的無限擴展<br />
23.3 架構基石:局部性、最終一致性與無共用<br />
23.4 結論:走向無限容量架構</p>
</div>
序
<div class="bd">
<div class="content more_off" id="M201105_0_getProdTextInfo_P00a400020009_h3">
<p><span style="color:#0000ff;"><strong>前言</strong></span><br />
?<br />
這是一本耗時很久才完成的書。<br />
幾年前,因新冠疫情,我頻繁被隔離在家。工作之餘,我閱讀了一篇介紹「費曼學習法」的文章,於是,為了讓自己對高併發、大規模系統架構的理解更上一層樓,我開始寫作「高併發的哲學原理」系列文章,這一寫就是3 個月,最終成文10 篇,共8 萬多字,發布的第11 天GitHub 上的Star 數就已過千。幾個月後,我將這些文字整理發布在微信公眾號上,又獲得了大量讀者的好評和鼓勵,這進而讓我萌生了將其擴充為一本實體書的想法。<br />
十幾年前,一位院士曾在贈予我的筆記本的扉頁上附言:「請把苦難當作玫瑰別在胸前,任何事,從現在開始做都不晚!」於是,我決定立刻行動,聯絡了電子工業出版社的付睿編輯,準備出版一本中等體量的技術圖書。本來計畫半年寫完,結果寫書的難度遠超想像,最後本書花費了好幾年才完成。<br />
?<br /><strong>為什麼要寫本書</strong><br />
我2014 年畢業於北京科技大學,大二時就開始與他人合夥創業,至今已經是第四次創業,仍在奮鬥中。從第一次創業開始,我一直擔任技術負責人的角色,各種技術難題都需要自己解決,我的知識全靠實踐與自學。相信讀到本書後面,你們也會發現,我的見解、觀點和技術方案都充滿了草莽氣息,但正是這種接地氣的實踐經驗,讓我對複雜系統設計有了深刻的理解。<br />
「高併發」是後端領域的技術聖杯,也是網際網路架構領域最具挑戰性的課題之一。在網際網路大企業的面試中,高併發系統架構設計是必不可少的焦點話題。隨著技術的飛速發展,我們已經從傳統的高併發時代進入了大模型時代,AI程式設計正在重塑整個產業的核心競爭力。面對這樣的技術劇變,架構設計的重要性愈發凸顯,它不僅是應對高併發的關鍵,也是在 AI 時代保持競爭力的核心。<br />
雖然我深知自己與頂尖網際網路大企業的工程師相比還有差距,但我的優勢在於一直身處架構設計、資料庫設計、程式碼撰寫,甚至是伺服器選型與配置的第一線,親手處理過各種規模的高併發問題,對此有著深刻的體悟。我的這些經驗非常有價值,尤其是在 AI 程式設計時代,架構思維能夠幫助我們更好地應對複雜的技術挑戰,這也是我寫作本書的原因。我希望透過分享我的實踐心得,幫助更多同行在複雜架構設計的道路上少走彎路,成為 AI 時代不可或缺的架構專家。<br />
?<br /><strong>我的高併發問題處理經驗</strong><br />
隨著「住范兒」的發展,我依次成功解決過如下的高併發問題。<br />
2017 年,我一個人維護單體CMS 系統,利用一台超低配虛擬機和一台超低配資料庫頂住了每日200 萬次PV 的壓力。<br />
2020 年,我最佳化了一個從外面購買的單體 PHP 商城,在實際業務中跑出了最高 1 分鐘 GMV 100 萬元人民幣、QPS 1000+ 的成績。<br />
2021 年,我從頭設計了一個分散式電商秒殺系統,在實際業務中跑出了最高1 分鐘GMV 1000 萬元人民幣、QPS 10000+ 的成績,產生訂單的TP99 時間小於200ms。<br />
此外,我還最佳化過單表一億多筆資料的 MySQL 資料庫,開源過索引了數千萬頁面的網際網路搜尋引擎,對降低各種業務類型的 API 延遲有非常豐富的經驗。<br />
?<br /><strong>讀者對象</strong><br />
本書面向所有關注複雜系統架構設計的技術從業者。無論你是剛踏上技術之路的新人工程師,還是具有一定經驗的中級開發者,或是負責團隊技術決策的管理者,都能在本書中找到適合自己的內容。<br />
對於初入行的工程師,本書透過「雙11」購物節和 DeepSeek 這樣的真實案例,為你提供了清晰的技術實踐指南,幫助你快速掌握複雜系統架構設計的基本技能。對於有經驗的開發者,本書深入剖析了每個技術方案背後的原理,討論不同方案的優劣權衡,幫助你在技術深度上更進一步。而對於技術管理者,本書著重分析技術架構、團隊組織、研發效能三者之間的內在聯繫,幫助你在做技術決策時進行更全面的思考。<br /><br /><br />
?</p>
</div>
書
評
其 他 著 作