庫存狀況
「香港二樓書店」讓您 愛上二樓●愛上書
我的購物車 加入會員 會員中心 常見問題 首頁
「香港二樓書店」邁向第一華人書店
登入 客戶評價 whatsapp 常見問題 加入會員 會員專區 現貨書籍 現貨書籍 購物流程 運費計算 我的購物車 聯絡我們 返回首頁
香港二樓書店 > 今日好書推介
   
二樓書籍分類
 
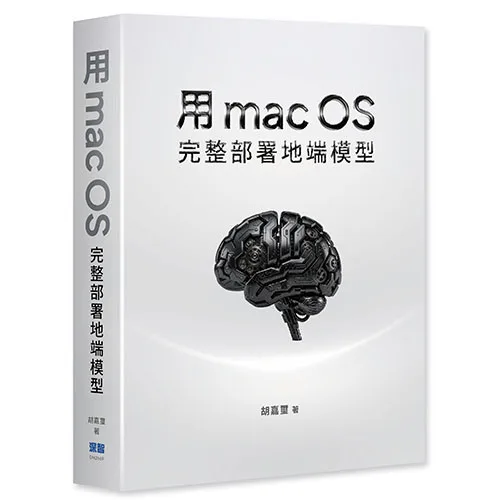
用 macOS 完整部署地端模型

用

沒有庫存
訂購需時10-14天
9786267889695
胡嘉璽
深智數位
2026年9月19日
360.00  元
HK$ 306  


ISBN:9786267889695
  • 規格:平裝 / 736頁 / 23 x 17 x 3.68 cm / 普通級 / 單色印刷 / 初版
  • 出版地:台灣


  • 電腦資訊 > 概論/科技趨勢 > 人工智慧/機器學習


    【書籍簡介】


    Apple Silicon 的統一記憶體,讓一台 Mac 就能執行過去要靠多張顯示卡才載得動的模型。 全書 25 章的操作、指令與畫面,都在 Mac 上實際執行過。

    ?

    -128GB 統一記憶體全部可當 GPU 記憶體,單機載入 100B 級模型。

    -Ghostty、Homebrew、uv 建好環境,Tailscale 與 macmon 遠端使用與監控。

    -Ollama、Open WebUI、LM Studio、llama.cpp 四套推論工具實際操作一遍。

    -四個方案同條件量測速度與記憶體,並與雲端 API 及 CUDA 主機對照。

    -mlx-lm 直接使用 MLX 框架,從命令列、Python API 到相容伺服器。

    -量化原理講清楚,實作 DWQ、AWQ、GPTQ 與 dynamic_quant。

    -推測式解碼、量化 KV 快取與 prompt 快取,同一個模型輸出更快。

    -mflux、Draw Things、ComfyUI 生圖,實測 FLUX.2、Z-Image 與 Wan 2.2。

    -mlx-whisper 轉寫、Kokoro 與 Qwen3-TTS 合成、MusicGen 與 ACE-Step 作曲。 -mlx-vlm 與 FastVLM 看圖看影片,AnythingLLM 與 LightRAG 讀自己的文件。 -Claude Code、goose 接地端模型,sandbox-exec 與 Apple container 隔離。

    -Foundation Models framework 呼叫系統模型,exo 與 MLX 分散式組叢集。

    -mlx_lm.lora、mflux-train、mlx-lm-lora 微調,nanochat-mlx 從零預訓練。

    ?

    適合手上已經有一台 Apple Silicon Mac,想把它當成地端 AI 主機使用的開發者與研究者。


    ?


    第一篇 硬體與系統建置
    第1 章 Apple Silicon 與 128GB 統一記憶體

    1-1 統一記憶體架構

    1-2 模型大小與記憶體

    1-3 頻寬與推論速度

    1-4 128GB 機型選購

    1-5 查看 Mac 硬體規格

    1-6 本章小結
    第2 章 macOS 系統準備與最佳化

    2-1 macOS 版本與更新

    2-2 開發工具安裝

    2-3 電源與休眠設定

    2-4 GPU 記憶體上限調整

    2-5 Time Machine 備份

    2-6 本章小結
    第3 章 終端機與開發環境建置

    3-1 終端機 Ghostty

    3-2 Homebrew 與基本工具

    3-3 Python 環境 uv

    3-4 Node.js 與 nvm

    3-5 Hugging Face CLI

    3-6 Claude Code

    3-7 本章小結
    第4 章 遠端存取與系統監控

    4-1 SSH 遠端登入

    4-2 螢幕共享

    4-3 Tailscale

    4-4 headless 主機

    4-5 系統監控

    4-6 本章小結
    第2 篇 地端模型推論入門
    第5 章 Ollama:命令列的模型執行器

    5-1 Ollama 與 MLX 引擎

    5-2 安裝與第一次執行

    5-3 模型庫與引擎實測

    5-4 多模態影像輸入

    5-5 API 服務與程式呼叫

    5-6 本章小結
    第6 章 WebUI:瀏覽器裡的模型工作台

    6-1 Open WebUI 的定位

    6-2 安裝與啟動

    6-3 對話與模型對比

    6-4 RAG 與知識庫

    6-5 工具擴充

    6-6 更新與維護

    6-7 本章小結
    第7 章 LM Studio:雙引擎的桌面模型環境

    7-1 LM Studio 的定位

    7-2 安裝與第一個模型

    7-3 lms 指令列工具

    7-4 API 服務

    7-5 載入參數調校

    7-6 LM Link 與 Locally

    7-7 與 Ollama 的比較與選擇

    7-8 本章小結
    第8 章 llama.cpp:所有工具背後的推論引擎

    8-1 llama.cpp 的定位

    8-2 安裝與編譯

    8-3 GGUF 模型下載

    8-4 llama-server 與 WebUI

    8-5 效能調校

    8-6 GGUF 與 MLX 兩套生態的關係

    8-7 本章小結
    第3 篇 MLX 推論進階
    第9 章 mlx-lm:直接使用 Apple 的機器學習框架

    9-1 MLX 框架

    9-2 安裝與第一次推論

    9-3 mlx-community 模型庫

    9-4 Python API

    9-5 mlx_lm.server

    9-6 本章小結
    第10 章 量化:用精度換記憶體與速度

    10-1 量化的原理

    10-2 mlx_lm.convert 的量化選項

    10-3 學習型量化

    10-4 品質與速度的實測比較

    10-5 量化等級的選擇

    10-6 本章小結
    第11 章 推論加速:讓同一個模型輸出更快

    11-1 推測式解碼的原理

    11-2 mlx-lm 的推測式解碼

    11-3 KV 快取的記憶體

    11-4 prompt 快取

    11-5 長脈絡的實測

    11-6 本章小結
    第12 章 方案比較:公平量測與工具選擇

    12-1 公平比較的條件

    12-2 四個方案同條件實測

    12-3 vLLM 生態在 Mac 上的現況

    12-4 與雲端及 CUDA 主機的對照

    12-5 選擇的判準

    12-6 本章小結
    第4 篇 多媒體 AI 生成
    第13 章 圖像與影片生成:擴散模型在 Mac 上的三個方法

    13-1 生圖模型的技術棧

    13-2 mflux:MLX 原生的命令列生圖

    13-3 Draw Things

    13-4 ComfyUI Desktop

    13-5 影片生成

    13-6 本章小結

    第14 章 音訊、語音與音樂 AI:從波形到 token

    14-1 聲音的表示與模型架構

    14-2 語音辨識

    14-3 語音合成與聲音複製

    14-4 即時語音對話

    14-5 音樂生成與音訊工具鏈

    14-6 本章小結
    第5 篇 多模態與 AI Agent
    第15 章 視覺語言模型:讓模型看懂圖像與影片

    15-1 圖像如何變成 token

    15-2 mlx-vlm 的圖片理解

    15-3 影片理解

    15-4 GUI 與 Apple 官方的 FastVLM

    15-5 包成 API:多模態的 OpenAI 相容服務

    15-6 本章小結
    第16 章 RAG 文件問答:讓模型讀自己的資料

    16-1 RAG 的三個零件

    16-2 AnythingLLM:零設定的文件問答

    16-3 embedding 模型的選擇

    16-4 LightRAG:知識圖譜加向量的雙路檢索

    16-5 圖譜與向量的分工

    16-6 本章小結
    第17 章 AI Agent 用地端模型

    17-1 Anthropic 相容端點的意義

    17-2 Claude Code 接 Ollama

    17-3 Claude Code 接 LM Studio

    17-4 goose:MCP 原生的開源 agent

    17-5 本地模型的 agent 限制

    17-6 把 agent 關進沙箱

    17-7 本章小結
    第18 章 編輯器裡的地端模型與 Vibe Coding

    18-1 編輯器接上本機模型

    18-2 程式開發的模型選擇

    18-3 Vibe Coding 實戰

    18-4 本章小結
    第6 篇 Apple 生態與多機延伸
    第19 章 Foundation Models framework

    19-1 系統內建的語言模型

    19-2 用 Swift 呼叫系統模型

    19-3 第三方模型接進同一套 API

    19-4 Core ML、ANE 與 MLX 的分工

    19-5 本章小結
    第20 章 多台Mac 組成推論叢集

    20-1 為什麼要多機

    20-2 Thunderbolt 直連與 RDMA

    20-3 MLX 分散式

    20-4 exo 叢集

    20-5 llama.cpp RPC

    20-6 方案比較與現實期望

    20-7 本章小結
    第7 篇 模型微調與訓練
    第21 章 用 MLX 微調自己的模型

    21-1 微調的方法與記憶體帳

    21-2 資料集準備

    21-3 用 mlx_lm.lora 訓練

    21-4 訓練監控與成果驗證

    21-5 合併、轉檔、接回工具

    21-6 其他微調框架的現況

    21-7 本章小結
    第22 章 影像模型的 LoRA 微調

    22-1 DreamBooth 與影像 LoRA

    22-2 準備訓練圖片與標註

    22-3 mflux-train 指令列訓練

    22-4 Draw Things 圖形介面訓練

    22-5 前後對照與 LoRA 運用

    22-6 其他訓練工具的現況

    22-7 本章小結
    第23 章 PyTorch MPS 後端的微調

    23-1 MPS 後端的現況

    23-2 transformers 加 PEFT 的 LoRA 微調

    23-3 sentence-transformers 微調embedding

    23-4 MLX 與 MPS 的選擇

    23-5 本章小結
    第24 章 偏好對齊:DPO 與GRPO

    24-1 三種對齊方法

    24-2 mlx-lm-lora 的 DPO 實測

    24-3 GRPO 推理訓練

    24-4 圖形介面的微調工具

    24-5 本章小結
    第25 章 從零預訓練一個模型t

    25-1 預訓練與微調的差別

    25-2 nanochat-mlx 的完整管線

    25-3 訓練監控

    25-4 其他預訓練工具

    25-5 本章小結
    附錄A 工具指令速查表

    A-1 Ollama

    A-2 lms(LM Studio CLI)

    A-3 llama.cpp

    A-4 mlx-lm 與 MLX 分散式

    A-5 多媒體生成與辨識

    A-6 Hugging Face 下載

    A-7 系統相關
    附錄B 推薦模型清單與效能基準

    B-1 對話與程式模型

    B-2 視覺語言模型

    B-3 語音模型

    B-4 音樂模型

    B-5 影像與影片生成模型

    B-6 embedding 模型

    B-7 128GB 記憶體對照
    附錄C 常見問題與故障排除

    C-1 安裝與下載

    C-2 記憶體

    C-3 推論

    C-4 微調

    C-5 其他
    附錄D 128GB 機型規格速查表

    D-1 機型總表

    D-2 各機型要點

    D-3 選擇建議

    D-4 參考資料


    序言


    2026 年進入下半年,結果整個AI 界大爆炸。首先就是開放權重模型如雨後春筍般湧出。開放權重模型從Llama 開始就一直存在,之前也一直維持百花齊放的樣貌,連台灣都有自己的TAIDE 模型。然而和主流前端模型相比,開放權重模型怎麼看都是個玩具。Anthropic 的CEO Dario Amodei 曾表示,開放權重模型和真正閉源的商用模型的差距大約在6 到18 個月。不過隨著LLM 這個領域逐漸收斂到幾個大廠之後,訓練LLM 及推論的成本也越來越高。

    ?

    首先就是DeepSeek 時刻。在各項評測的指標中,竟然能做到「接近」閉源商用模型的品質。讓人不禁懷疑那些號稱世界領導廠商的OpenAI、Anthropic、Google、xAI 有這麼強嗎?雖然大家還是流行使用這些商用模型,但如果有足夠的硬體,誰都會想試試開放權重這種自由自在的感覺,因為模型權重可以下載,可以在本機(我們稱為地端)執行,這讓企業首次能在私有雲內執行LLM 的推論,讓著重安全的企業也開始考慮。

    ?

    結果真正爆炸的時刻就是2026 年的下半年。首先是GLM-5.2 模型首度在Arena.ai 的排行榜進入程式開發的前三名,甚至領先主流的商用模型。正當大家以為這次是曇花一現時,Kimi-K3 竟然直接攻頂,並且在之後不久也開放權重。事情還沒完,然後就是DeepSeek-V4-Flash 0731 的出現。大家都嚇到了,從來沒有開放權重在排行榜上進入前20 名,一轉眼,這些來自東方的開放權重模型竟然都在排行榜的前五名,更不用說之後推出的Qwen 3.8 Max 了。

    ?

    雖然開放權重可以部署在地端,但要部署的成本很高,這些動輒2.8T參數的模型,至少要上億台幣的機器才能在地端部署起來,企業是不可能在完全沒有評估的情況下直接購買,這時如果能先把參數較小的版本拿來做POC,確認合用再採購硬體才是正確的做法。

    ?

    輝達推出了DGX Spark 128GB 的產品讓你做到這件事,然而DGX Spark 執行在Linux 上,不是主流的作業系統,使用起來比較麻煩。有沒有用手上的電腦就能完成測試的辦法?答案早就出來了,就是蘋果的M 系列架構。

    ?

    在個人電腦上使用LLM,蘋果是第一個能做到的硬體,因為早在2020 年就推出了M1 晶片,使用的正是統一記憶體架構,而到M3 Ultra 這台機器上,更是有了512GB 的記憶體,可以載入非常大的模型。之後延續的M4、M5 雖然沒有這麼多的記憶體,但至少有128GB,這也讓在蘋果上執行LLM 的各種功能成為可能。

    ?

    本書就是在一台M4 32GB 的MacBook Air 和一台M5 128GB 的MacBookPro 上撰寫的。不用多,只要有32GB 以上的記憶體,你可以做到文、圖、影、音的產生和對話,更可以執行現在最流行的Agent 程式。如果你使用的是128GB的電腦,你更可以自己從頭預訓練一個完整的LLM。這本書就是為了這些目的而撰寫的。只要有一台Mac,你完全可以做到和DGX Spark 一模一樣的事情甚至是更多,在你熟悉的macOS 操作,而豐富的Metal/MLX 生態系更不會輸給CUDA。最重要的是,你這台Mac 還能當平常的電腦使用,剪片、上網、看視訊、玩遊戲等,這比DGX Spark 還要全能,更適合擁有。

    ?

    隨著開放權重模型的普及,不管是LLM、生圖、生文、生影片(MiniMaxH3),預訓練、QLoRA、PEFT、DPO、GRPO 這些從前只出現在書本或別人電腦上的技術,現在全部在自己的Mac 上就可以執行,而且效能甚至超越了閉源商用模型。

    ?

    地端模型絕對不是玩具,它們已經佔了很大一部分企業及個人的商業應用,如果你不想花時間在不熟悉的Linux 上,只要有32GB 以上的Mac,你什麼都做得到,希望本書能拋磚引玉,讓AI 的民主化更進一步,最前端的技術不再只掌握在少數幾個寡頭手上,每個人都能享用科技的進步,再加上macOS 的親切熟悉,現在正是直接跳入地端模型的最佳時刻。

    ?

    ?


    胡嘉璽

    2026年8月10日


    ?


    其 他 著 作
    1. 手刻Coding Agent更好玩 - 使用Pi Agent玩通雲端地端模型取代Claude Code
    2. Harness 強大應用 - Codex App 超越 Coding Agent 實戰大全
    3. 工作學習生活一手包辦 - Claude Cowork 31 個超好用範例實作
    4. 塞爆 128G GPU 記憶體,Nvidia DGX Spark,影音圖生成、微調、預訓練 Agent 全面玩透
    5. 勝過 AI 的技能 - 玩熟 Mermaid 做出最專業的圖表
    6. Coding Agent 大神 - Google Antigravity 最強實戰指南
    7. Sutskever 大神推薦 - 建構AI世界最重要的30篇論文:用PyTorch完整實作
    8. 玩爆你的龍蝦 — 最強 OpenClaw 安裝設定應用實機演練
    9. Vibe Coding CLI 頂級開發:Claude Code 前瞻菁英育成手冊
    10. Vibe Coding:Cursor教戰手冊