


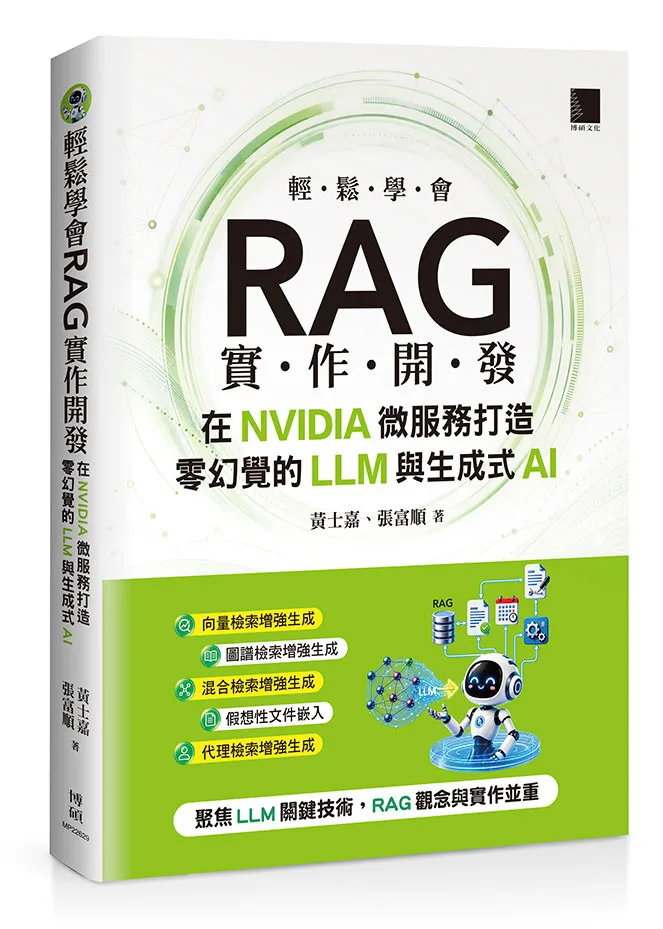


聚焦LLM關鍵技術,RAG觀念與實作並重
?
【內容簡介】
在生成式AI的浪潮下,檢索增強生成(Retrieval-Augmented Generation,RAG)已成為大型語言模型(LLM)的關鍵技術。由於LLM受限於訓練資料的時效性與涵蓋範圍,面對即時議題時容易引用過時知識,而在處理企業內部問題時,也常因缺乏私有數據而產生幻覺現象(Hallucination),為了改善上述問題,RAG技術應運而生,透過在生成答案前先從外部資料庫檢索相關資料,並提供給LLM作為回答依據,成為目前業界最主流的解決方案。
本書共分為6章,第0章完成開發環境建置,第1至5章依序帶入向量檢索增強生成(Vector RAG)、圖譜檢索增強生成(Graph RAG)、混合檢索增強生成(Hybrid RAG)、假想性文件嵌入(Hypothetical Document Embeddings,HyDE)與代理檢索增強生成(Agentic RAG)。各章以深入淺出的方式,帶領讀者從零開始、循序漸進地學習RAG的基礎知識與運作原理,並以「圖書館智慧問答系統」為情境,透過NVIDIA NIM微服務取得免費LLM資源,並搭配Docker Desktop部署Milvus向量資料庫與Neo4j圖資料庫進行實務開發,讓讀者觀念與實作並重,在短時間內快速上手。
【精彩內容】
?完成開發環境建置:在Windows 11安裝Python、Docker Desktop與VS Code,完成NVIDIA NIM帳號註冊、API Key申請與模型挑選,並學習Git與GitHub版本控制的基本操作。
?認識檢索增強生成(RAG):瞭解LLM在未整合RAG時常見的幻覺現象(Hallucination)、引用過時知識、缺乏企業私有數據等問題。
?認識向量檢索增強生成(Vector RAG):瞭解Vector RAG是如何突破傳統「關鍵字字面比對」的限制,改以語意檢索(Semantic Search)找出語意相關的資料。
?認識圖譜檢索增強生成(Graph RAG):瞭解Graph RAG是如何透過三個主要階段,將外部文件轉化為可查詢的知識圖譜,並從中檢索與使用者提問相關的實體關聯脈絡。
?認識混合檢索增強生成(Hybrid RAG):瞭解Vector RAG與Graph RAG在檢索架構上的優缺點。
?認識假想性文件嵌入(HyDE):瞭解HyDE是如何透過LLM生成假想文件,縮短使用者問題與文件片段間的語意落差,進而提升檢索精準度。
?認識代理檢索增強生成(Agentic RAG):瞭解AI Agent是如何運用工具(Tool)、技能(Skill)與ReAct迴圈,自主完成檢索任務。
?