{itemname}
{itemname}
香港二樓書店 > 今日好書推介
日本人也不知道的日本語3:敬語、人物對話、書信書寫、文化歷史……學會連日本人都會對你說「讚」的正確日語
定價87.00元
8
折優惠:
HK$69.6
●二樓推薦
●文學小說
●商業理財
●藝術設計
●人文史地
●社會科學
●自然科普
●心理勵志
●醫療保健
●飲 食
●生活風格
●旅 遊
●宗教命理
●親子教養
●少年讀物
●輕 小 說
●漫 畫
●語言學習
●考試用書
●電腦資訊
●專業書籍
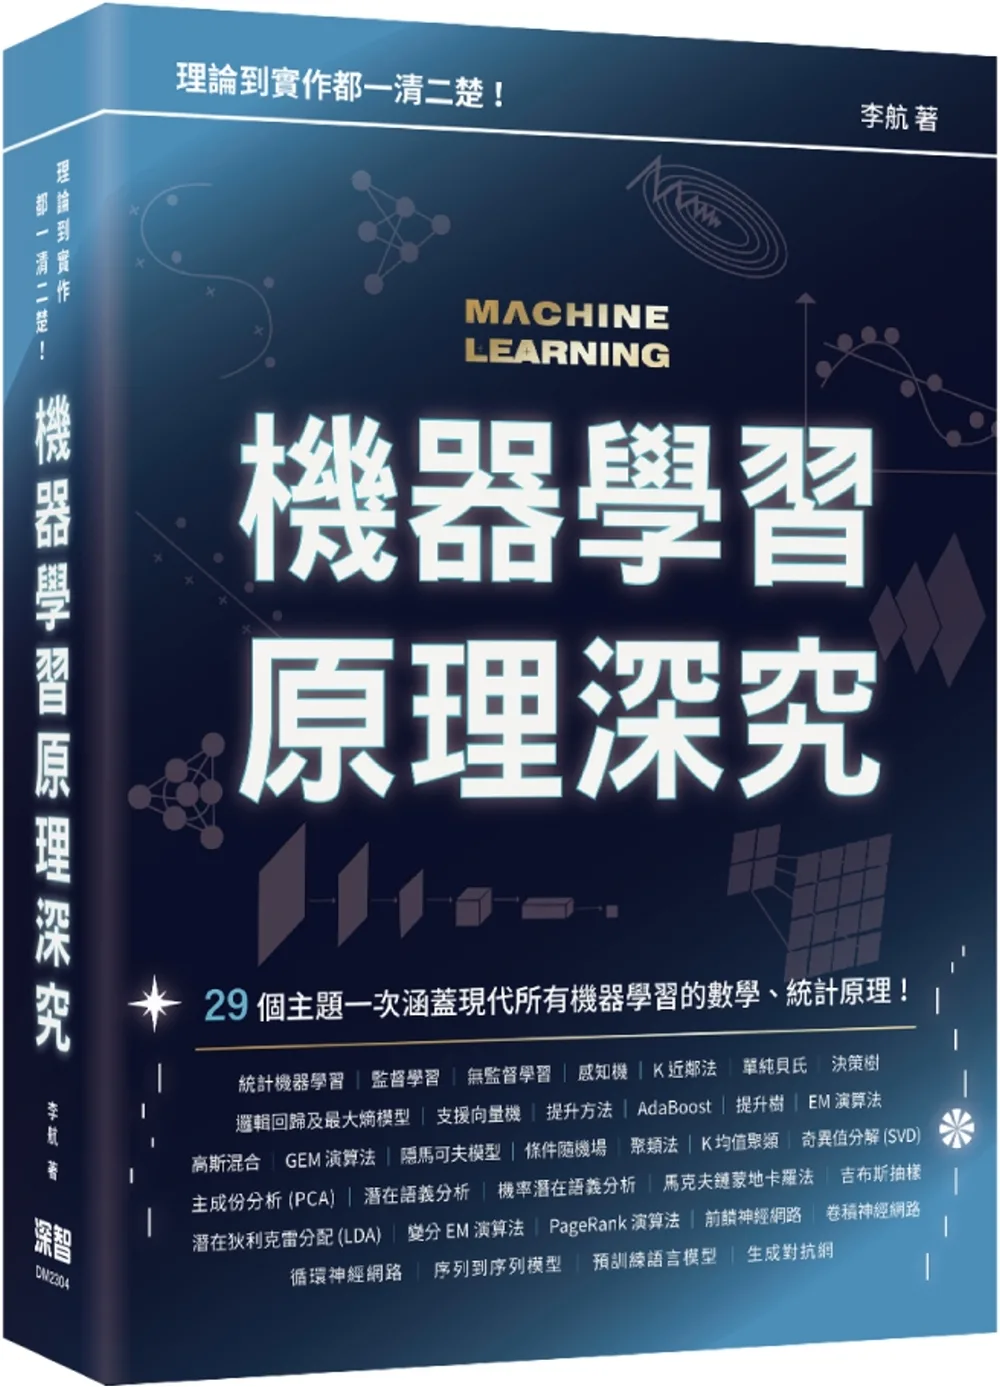
理論到實作都一清二楚:機器學習原理深究
沒有庫存
訂購需時10-14天
9786267146880
李航
深智數位
2023年1月18日
333.00 元
HK$ 283.05
詳
細
資
料
ISBN:9786267146880</li><li>規格:平裝 / 784頁 / 17 x 23 x 3.41 cm / 普通級 / 單色印刷 / 初版</li><li>出版地:台灣
分
類
電腦資訊
>
概論/科技趨勢
>
人工智慧/機器學習
內
容
簡
介
<div class="bd">
<div class="content" style="height:auto;">
<div style="text-align: center;"><strong>◇◆◇ 29 個主題一次涵蓋現代所有機器學習的數學、統計原理!◇◆◇</strong></div>
<br>
人們透過機器學習,試著讓電腦能夠從大量資料中學習成長,不僅可以運用在生活各方面的功能提升,甚至還能透過這些既有的資料,起到鑑往知來的效果,處在當今資訊爆炸的時代,正是你開始學機器學習的最好時機!<br>
<br>
本書收錄了關於機器學習最重要的統計應用及數學原理,全書分成了監督學習和無監督學習,以及深度學習三大區塊。<br>
<br>
在監督學習部分,介紹了最基本的三大問題——分類、回歸、標注,並針對這三大問題,介紹各種解決方法。包括了感知機、K近鄰法、單純貝氏法、決策樹、邏輯回歸、最大熵模型、擬牛頓法、支援向量機(SVM)、各種提升法(Boost)、EM演算法、隱馬可夫模型、條件隨機場等等,在監督學習也特別獨立出一章來複習整合這些演算法。<br>
<br>
而在無監督學習上,則介紹了當代最重要的幾個演算法及模型,包括了聚類方法(如K均值)、奇異值分解(SVD)、主成分分析(PCA)、潛在語義分析(包括了最流行的向量空間)、機率潛在語義分析等。在較進階的應用上,也介紹了馬可夫鏈蒙地卡羅法、吉布斯抽樣、潛在狄利克雷分配模型,另外奠定Google基本的PageRank演算法也有詳細的說明。<br>
<br>
在深度學習的部分,也有前饋神經網路、卷積神經網路、循環神經網路、序列到序列模型、預訓練語言模型、生成對抗網路等,以及最後的深度學習方法總結,是想要完備機器學習知識的讀者,不容錯過的集大成之作!<br>
<br>
【適合讀者】<br>
● 機器學習相關學習者。<br>
● 從事資訊檢索、自然語言處理等領域的學生與研究人員。<br>
● 從事機器學習的專業研究人員。
</div><div class="type02_gradient" style="display:none;"></div>
</div></div><div class="mod_b type02_m057 clearfix">
<a name="AuthorP00a400020009"> </a>
目
錄
<div class="bd">
<div class="content more_off" id="M201105_0_getProdTextInfo_P00a400020009_h2">
<strong>◎ 第1篇 監督學習<br>
1 機器學習及監督學習概論</strong><br>
1.1 機器學習<br>
1.2 機器學習的分類<br>
1.3 機器學習方法三要素<br>
1.4 模型評估與模型選擇<br>
1.5 正規化與交叉驗證<br>
1.6 泛化能力<br>
1.7 生成模型與判別模型<br>
1.8 監督學習應用<br>
<br>
<strong>2. 感知機</strong><br>
2.1 感知機模型<br>
2.2 感知機學習策略<br>
2.3 感知機學習演算法<br>
<br>
<strong>3. k 近鄰法</strong><br>
3.1 k 近鄰演算法<br>
3.2 k 近鄰模型<br>
3.3 k 近鄰法的實現:kd 樹<br>
<br>
<strong>4. 單純貝氏法</strong><br>
4.1 單純貝氏法的學習與分類<br>
4.2 單純貝氏法的參數估計<br>
<br>
<strong>5. 決策樹</strong><br>
5.1 決策樹模型與學習<br>
5.2 特徵選擇<br>
5.3 決策樹的生成<br>
5.4 決策樹的剪枝<br>
5.5 CART 演算法<br>
<br>
<strong>6. 邏輯回歸與最大熵模型</strong><br>
6.1 邏輯回歸模型<br>
6.2 最大熵模型<br>
6.3 模型學習的最佳化演算法<br>
<br>
<strong>7. 支持向量機</strong><br>
7.1 線性可分支持向量機與硬間隔最大化<br>
7.2 線性支持向量機與軟間隔最大化<br>
7.3 非線性支持向量機與核函數<br>
7.4 序列最小最佳化演算法<br>
<br>
<strong>8. 提升方法</strong><br>
8.1 提升方法AdaBoost 演算法<br>
8.2 AdaBoost 演算法的訓練誤差分析<br>
8.3 AdaBoost 演算法的解釋<br>
8.4 提升樹<br>
<br>
<strong>9. EM 演算法及其推廣</strong><br>
9.1 EM 演算法的引入<br>
9.2 EM 演算法的收斂性<br>
9.3 EM 演算法在高斯混合模型學習中的應用<br>
9.4 EM 演算法的推廣<br>
<br>
<strong>10. 隱馬可夫模型</strong><br>
10.1 隱馬可夫模型的基本概念<br>
10.2 機率計算演算法<br>
10.3 學習演算法<br>
10.4 預測演算法<br>
<br>
<strong>11. 條件隨機場</strong><br>
11.1 機率無向圖模型<br>
11.2 條件隨機場的定義與形式<br>
11.3 條件隨機場的機率計算問題<br>
11.4 條件隨機場的學習演算法<br>
11.5 條件隨機場的預測演算法<br>
<br>
<strong>12. 監督學習方法總結</strong><br>
<br>
<strong>◎ 第2篇 無監督學習<br>
13. 無監督學習概論</strong><br>
13.1 無監督學習基本原理<br>
13.2 基本問題<br>
13.3 機器學習三要素<br>
13.4 無監督學習方法<br>
<br>
<strong>14. 聚類方法</strong><br>
14.1 聚類的基本概念<br>
14.2 層次聚類<br>
14.3 k 均值聚類<br>
<br>
<strong>15. 奇異值分解</strong><br>
15.1 奇異值分解的定義與性質<br>
15.2 奇異值分解的計算<br>
15.3 奇異值分解與矩陣近似<br>
<br>
<strong>16. 主成分分析</strong><br>
16.1 整體主成分分析<br>
16.2 樣本主成分分析<br>
<br>
<strong>17. 潛在語義分析</strong><br>
17.1 單字向量空間與話題向量空間<br>
17.2 潛在語義分析演算法<br>
17.3 非負矩陣分解演算法<br>
<br>
<strong>18. 機率潛在語義分析</strong><br>
18.1 機率潛在語義分析模型<br>
18.2 機率潛在語義分析的演算法<br>
<br>
<strong>19. 馬可夫鏈蒙地卡羅法</strong><br>
19.1 蒙地卡羅法<br>
19.2 馬可夫鏈<br>
19.3 馬可夫鏈蒙地卡羅法<br>
19.4 Metropolis-Hastings 演算法<br>
19.5 吉布斯抽樣<br>
<br>
<strong>20. 潛在狄利克雷分配</strong><br>
20.1 狄利克雷分佈<br>
20.2 潛在狄利克雷分配模型<br>
20.3 LDA 的吉布斯抽樣演算法<br>
20.4 LDA 的變分EM 演算法<br>
<br>
<strong>21. PageRank 演算法</strong><br>
21.1 PageRank 的定義<br>
21.2 PageRank 的計算<br>
<br>
<strong>22. 無監督學習方法總結</strong><br>
22.1 無監督學習方法的關係和特點<br>
22.2 話題模型之間的關係和特點<br>
<br>
<strong>◎ 第3篇 深度學習</strong><br>
<strong>23. 前饋神經網路</strong><br>
23.1 前饋神經網路的模型<br>
23.2 前饋神經網路的學習演算法<br>
23.3 前饋神經網路學習的正規化<br>
<br>
<strong>24. 卷積神經網路</strong><br>
24.1 卷積神經網路的模型<br>
24.2 卷積神經網路的學習演算法<br>
24.3 影像分類中的應用<br>
<br>
<strong>25. 循環神經網路</strong><br>
25.1 簡單循環神經網路<br>
25.2 常用循環神經網路<br>
25.3 自然語言生成中的應用<br>
<br>
<strong>26. 序列到序列模型</strong><br>
26.1 序列到序列基本模型<br>
26.2 RNN Search 模型<br>
26.3 Transformer 模型<br>
<br>
<strong>27. 預訓練語言模型</strong><br>
27.1 GPT 模型<br>
27.2 BERT 模型<br>
<br>
<strong>28. 生成對抗網路</strong><br>
28.1 GAN 基本模型<br>
28.2 影像生成中的應用<br>
<br>
<strong>29. 深度學習方法複習</strong><br>
29.1 深度學習的模型<br>
29.2 深度學習的方法<br>
29.3 深度學習的最佳化演算法<br>
29.4 深度學習的優缺點
</div>
序
<div class="bd">
<div class="content more_off" id="M201105_0_getProdTextInfo_P00a400020009_h3">
<strong>序言</strong><br>
<br>
2012年《統計學習方法(第1版)》出版,內容涵蓋監督學習的主要方法,2019年第2版出版,增加了無監督學習的主要方法,都屬於傳統機器學習。在這段時間裡,機器學習領域發生了巨大變化,深度學習在人工智慧各個應用方向獲得了巨大突破,成為機器學習的主流技術,徹底改變了機器學習的面貌。有些讀者希望能看到與之前風格相同的講解深度學習的書籍,這也觸發了作者在原來《統計學習方法》的基礎上增加深度學習內容的想法(計畫今後再增加強化學習)。從2018年開始,歷時3年左右,完成了深度學習的寫作。<br>
<br>
考慮到內容的變化,現將書名更改為《機器學習原理深究》。第1篇監督學習和第2篇無監督學習基本為原來的內容,增加第3篇深度學習,希望對讀者有所裨益。傳統機器學習是深度學習的基礎,所以將這些內容放在一本書裡說明也有其合理之處。雖然深度學習目前是大家關注的重點,但傳統機器學習仍然有其不容忽視的地位。事實上,傳統機器學習和深度學習各自有更適合的應用場景,比如,深度學習長於巨量資料、複雜問題的預測,特別是人工智慧的應用;傳統機器學習善於小資料、相對簡單問題的預測。<br>
<br>
本書的定位是講解機器學習的基本內容,並不完全是入門書。介紹的內容都是最基本的,在這種意義上適合初學者。但主旨是把最重要的原理和方法做系統的複習,方便大家經常閱讀和複習。在寫第3篇的時候也接受大家對第1篇和第2篇的回饋意見,在力求文字簡練清晰的同時,也確保敘述的詳盡明了,以方便讀者理解。在各章方法的匯入部分適當增加了背景和動機的介紹。<br>
<br>
第3篇中使用的數學符號與第1篇和第2篇有一定的對應關係,但由於深度學習的特點也有一些改變,也都能自成系統。將符號完全統一於一個框架內還需要做大量的工作,希望在增加第4篇強化學習之後再做處理。對第3篇的原稿,鄭詩源、張新松等幫助做了校閱,對一些章節的內容提出了寶貴的意見。責任編輯王倩也為本書的出版做了大量工作。在此對他們表示衷心的感謝。
<div style="text-align: right;"><br>
李航</div>
書
評
其 他 著 作